퇴근길 지하철에서 장을 보려고 컬리 앱을 엽니다. 홈에는 ‘지금 가장 많이 담는 특가’, ‘놓치면 후회할 가격’ 같은 추천 컬렉션이 떠 있고, 거기서 상품 하나를 무심코 장바구니에 담습니다. 어느새 추천 모델은 통째로 바뀌어 고객에게 더 잘 맞는 상품을 보여 주고 있었지만, 컬렉션 결과가 전과 달라졌다는 건 아마 눈치채지 못하셨을 겁니다.
안녕하세요. 컬리 AI검색추천개발의 백엔드 엔지니어 유성규입니다. 저희는 고객님들이 매일 보시는 추천 상품을 더 개인화하려고 추천 모델의 학습부터 서비스 반영까지 자동으로 이어지는 파이프라인을 만들었습니다.
‘매일매일 새로 학습한 모델을 서비스에 올리면 된다.’ 말로는 간단하지만 막상 만들려고 보니 백엔드 엔지니어로서 고민할 부분이 적지 않았습니다. 무엇보다 모델을 새로 바꾸려면 추론 엔드포인트와 유저 임베딩, 검색 인덱스가 함께 바뀌어야 했는데, 저마다 다른 AWS 서비스에 흩어져 있어서 어떻게 한꺼번에 교체할지가 문제였습니다.
고민 끝에 산출물을 하나씩 바꾸면서 트랜잭션을 어떻게 보장할지 따지는 대신 세대(Generation)를 구분하는 구조를 택했습니다. 서비스가 어느 세대를 쓸지 가리키는 활성 키를 두고, 그 값만 바꾸면 세대가 전환되게 만들었습니다. 비유하자면 영업 중인 매장은 그대로 두고 옆 칸에 새 매장을 통째로 차려 둔 다음, 준비가 끝나면 입구 간판의 화살표만 돌리는 식입니다.
이 글에서는 모델을 잘 학습시켜 좋은 성과를 내는 방법보다 잘 학습된 모델을 서비스에 올리는 과정을 이야기하려고 합니다. 자동화 파이프라인을 만들며 부딪힌 문제들을 짚어 가면서, 그때마다 무엇을 고민했고 어떤 선택을 했는지 순서대로 풀어 보겠습니다.
풀어야 했던 문제
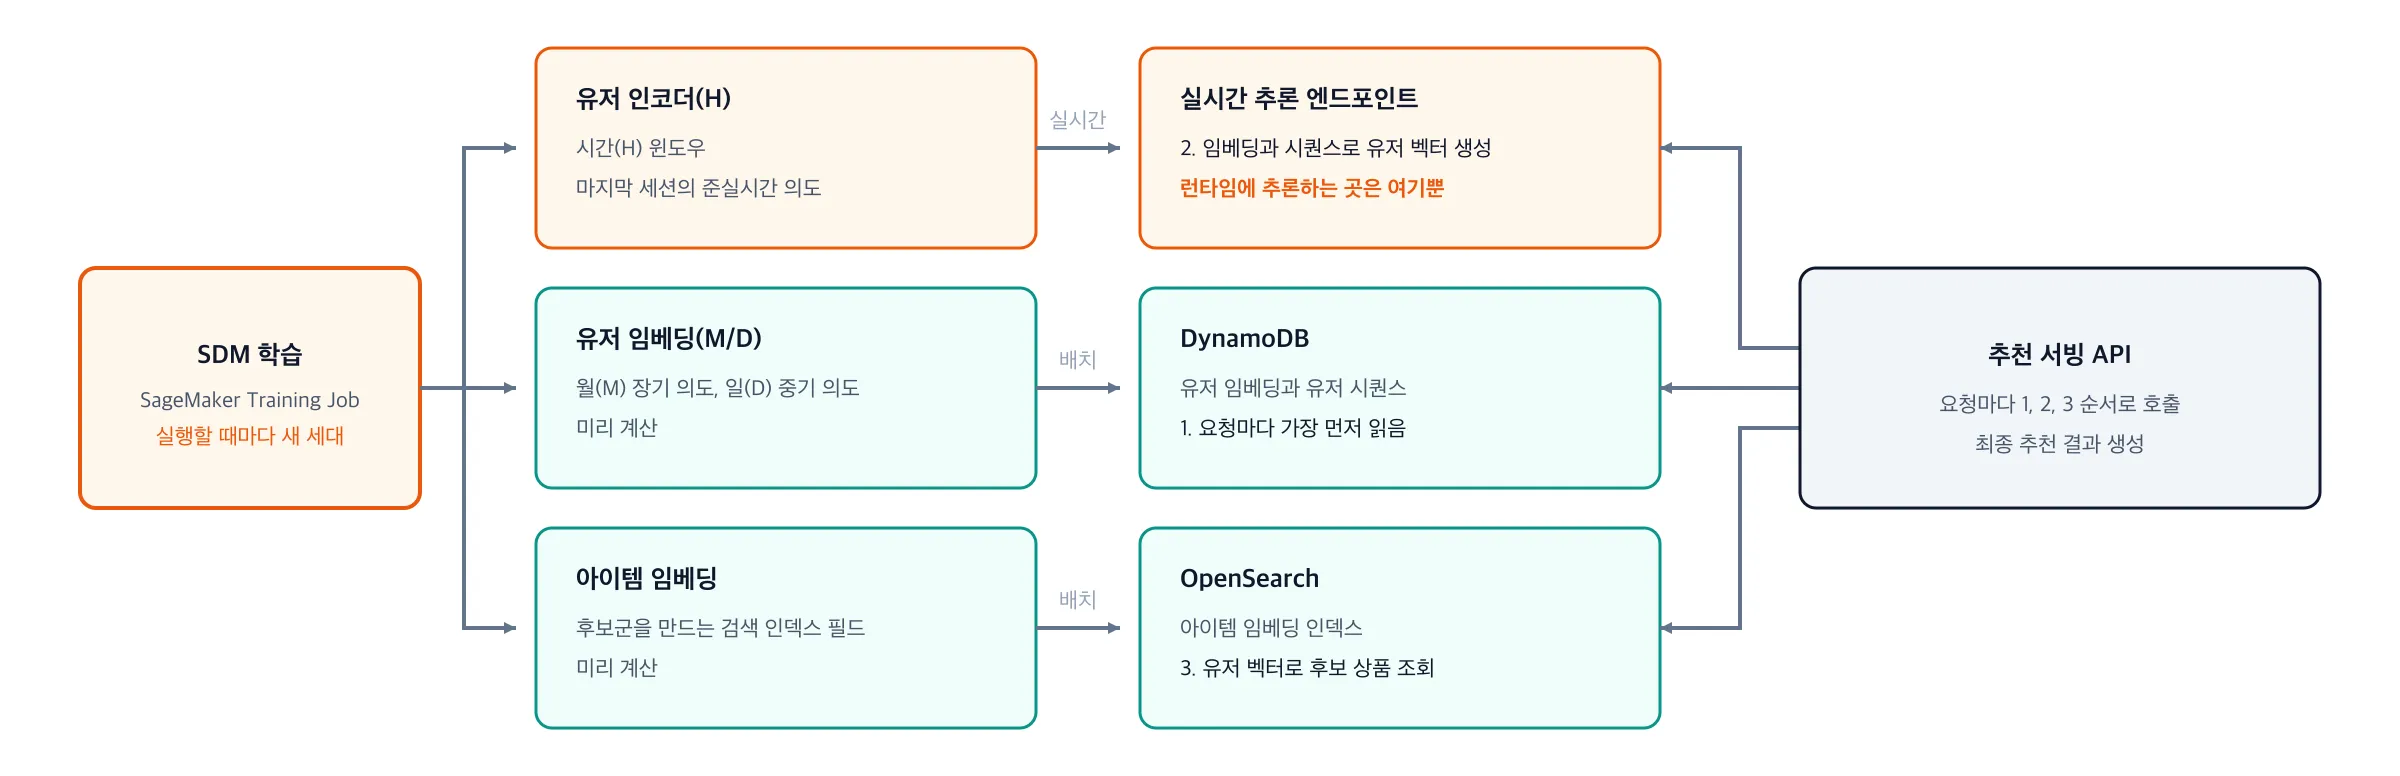
저희가 서비스에 넣으려던 SDM(Sequential Deep Matching) 계열 모델은 학습을 한 번 돌리면 아래 표처럼 성격이 다른 산출물이 여러 개 나옵니다.
| 산출물 | 역할 | 서빙 방식 |
|---|---|---|
| 유저 인코더(H) | 시간(H) 윈도우로 마지막 세션의 준실시간 의도 파악 | 실시간 추론 엔드포인트 |
| 유저 임베딩(M/D) | 월(M) 윈도우의 장기 의도와 일(D) 윈도우의 중기 의도 표현 | 미리 계산해 DynamoDB에 적재 |
| 아이템 임베딩 | 후보군을 만드는 검색 인덱스 필드 | 미리 계산해 OpenSearch에 적재 |
요청이 들어오면 서빙 API는 저장소에서 유저 임베딩 벡터와 유저의 최근 행동 시퀀스(이하 유저 시퀀스)를 읽어 유저 인코더 추론 엔드포인트에 넘깁니다. 엔드포인트는 이 입력으로 유저 벡터를 만들어 돌려주고, 서빙 API는 그 벡터로 검색 엔진(OpenSearch)에서 후보 상품을 조회해 최종 결과를 만듭니다.
(그림: 컬리, © 2026. Kurly. All rights reserved.)
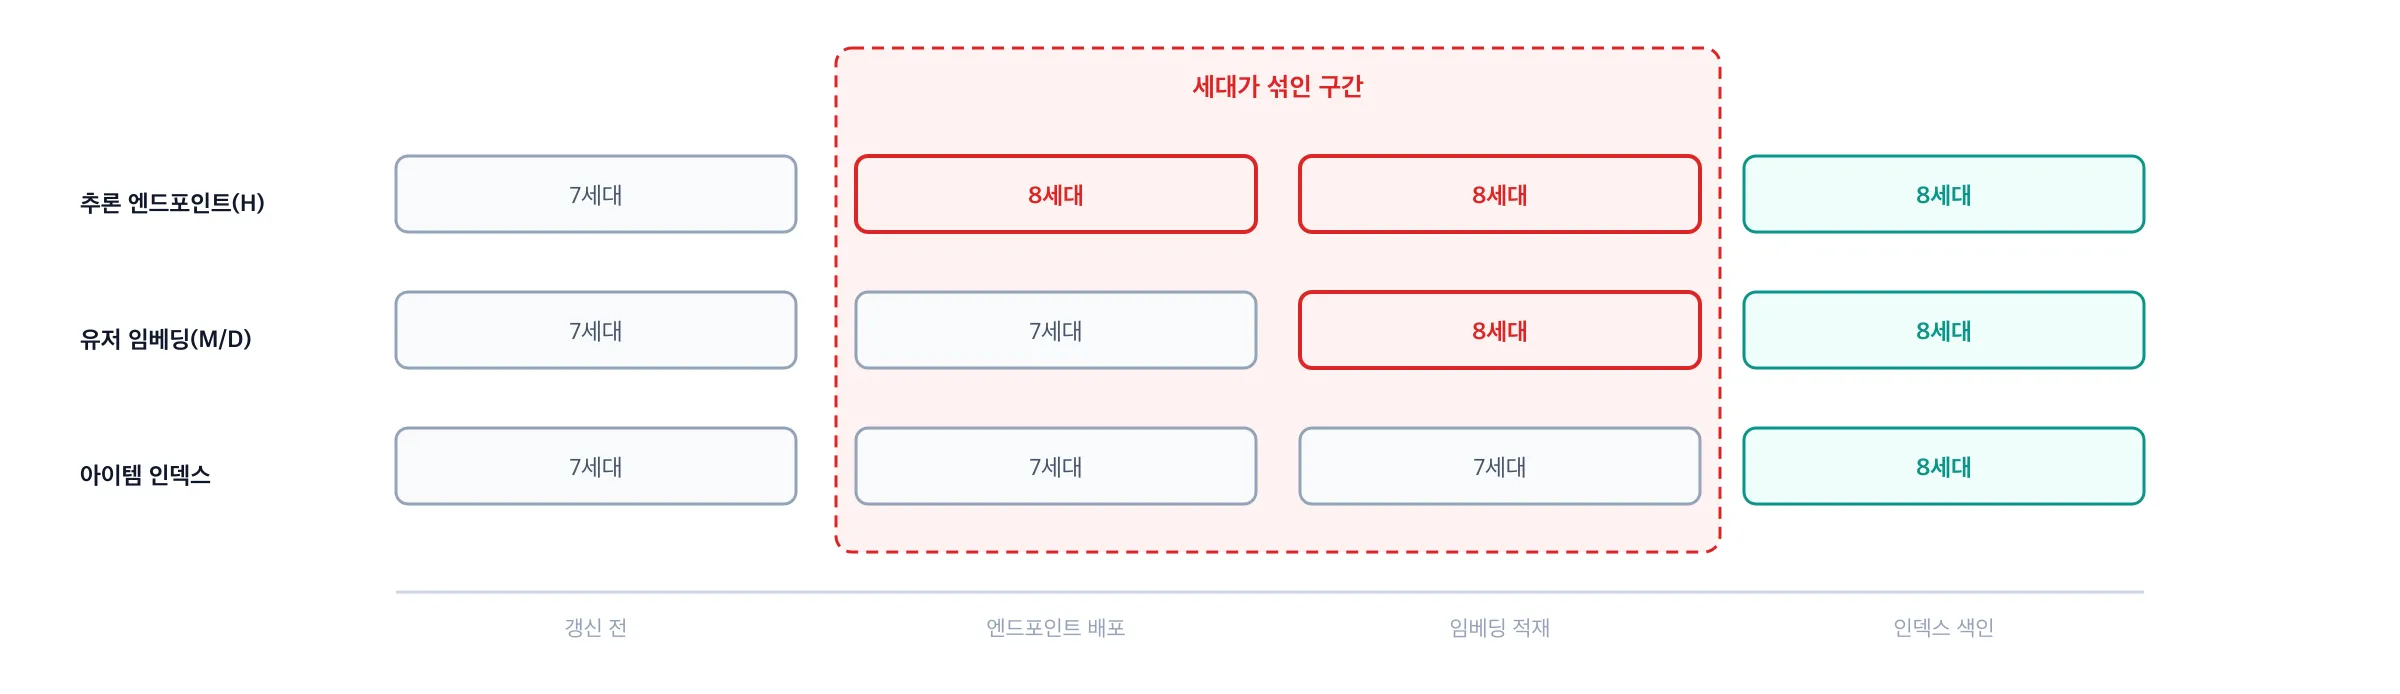
까다로운 부분은 여기서부터인데, 세대가 다른 벡터끼리는 서로 다른 공간에 놓여 있어서 섞어 쓰면 추천 품질이 떨어집니다. 그래서 추론과 벡터 검색에는 반드시 같은 세대의 임베딩과 유저 시퀀스를 써야 합니다.
(그림: 컬리, © 2026. Kurly. All rights reserved.)
지금까지 정리한 문제를 바탕으로 요구사항을 추려 보면 다음과 같습니다.
- 학습부터 색인까지 매일 자동으로 이어져야 합니다.
- 모든 산출물이 한 세대로 묶여 동시에 전환되어야 합니다.
- 파이프라인이 중간에 실패해도 서비스 중인 모델에는 영향이 없어야 합니다.
- 추론이 불가능한 모델은 서비스로 전환하기 전에 걸러내야 합니다.
이제 이 요구사항에 맞춰 구현에 쓸 도구를 고르고 아키텍처를 설계해야 했습니다.
Argo와 SageMaker를 고른 이유
ML 파이프라인이다 보니 처음에는 학습 데이터 전처리에 자주 쓰이는 Airflow도 후보에 올렸습니다. Airflow는 데이터 처리에 최적화돼 있으면서 작업 흐름 제어에도 쓸 만한 워크플로우 엔진이지만, 저희에게는 특정 언어에 묶이지 않고 작업 흐름을 정의할 수 있는 범용성이 더 중요했습니다. 마침 전사 표준 아키텍처로 EKS를 채택한 상태여서 컨테이너 기반의 범용 워크플로우 엔진인 Argo Workflows를 자연스럽게 검토하게 됐습니다. Argo는 이미 알려진 모범 사례가 많았고, 저희가 구현할 파이프라인 흐름도 Argo가 제공하는 기능에서 크게 벗어나지 않았습니다.
고민은 오히려 ML 런타임 쪽에서 깊어졌습니다. 아키텍처를 설계하던 시점에는 하루 한 번, 평균 4~5시간 GPU를 쓰는 학습이 있었는데, 그 몇 시간을 위해 GPU 노드를 24시간 띄워 두는 건 비효율적이라고 생각했습니다. 그렇다고 비용을 아끼려고 GPU 노드 제어는 물론 학습 스케줄링까지 직접 구현하자니 따져 볼 것이 많아서, 이 부분은 관리형 서비스에 맡기는 편이 낫겠다고 판단했습니다.
추론 쪽은 EKS 위에 MLflow와 KServe, Karpenter를 조합하는 방안을 먼저 검토해 PoC까지 진행했습니다. 백엔드 엔지니어 입장에서는 Kubernetes 패턴으로 서빙을 구현해 두면 나중에 확장하기에 더 유연하다고 봤지만, 당시에는 추론 모델 아키텍처가 정해지기 전이라 GPU 서빙까지 염두에 둬야 했습니다. 학습과 마찬가지로 GPU 노드 운용과 비용 통제를 직접 챙기고, 모델 버전과 승인 상태를 관리할 레지스트리까지 따로 만들려니 부담이 컸습니다.
인프라 조직과 논의한 끝에 저희 상황에는 SageMaker가 맞는다는 결론을 내렸습니다. 앞에서 짚은 GPU 노드 운용과 스케줄링을 관리형 서비스에 맡길 수 있고, 모델 버전과 승인 상태를 담을 레지스트리도 이미 갖춰져 있었습니다. 게다가 학습은 잡 단위로만 과금되고, 학습 도중 GPU 장애가 나더라도 S3에 남은 체크포인트에서 이어 갈 수 있어서 가용성 걱정과 개발 공수 부담도 함께 덜 수 있었습니다.
역할 분담
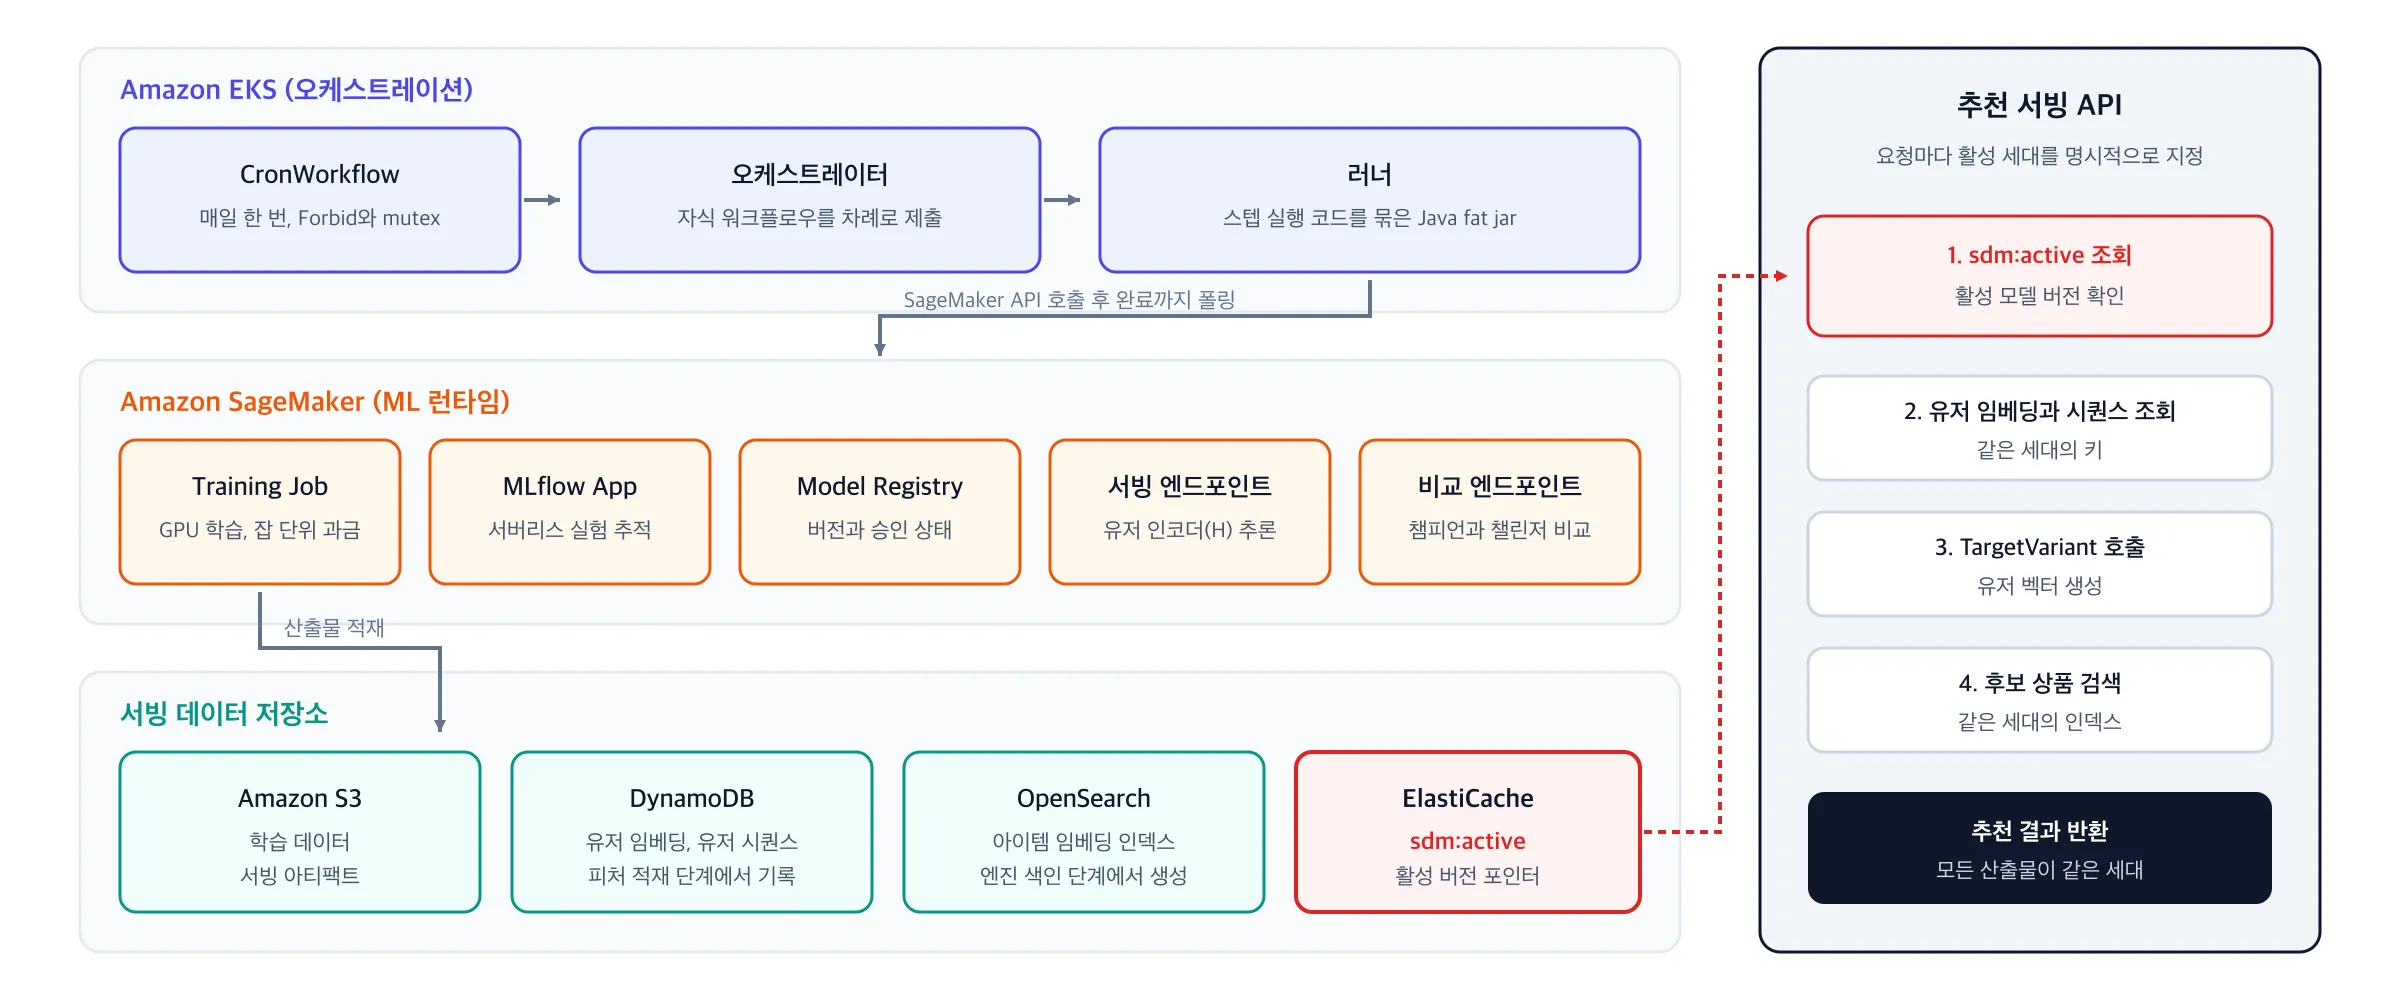
(그림: 컬리, © 2026. Kurly. All rights reserved.)
이 하이브리드 구성에서는 GPU 연산과 모델 상태는 SageMaker가, 작업 순서와 조건 판정은 Argo가 맡도록 역할을 나눴습니다. Argo는 Model Registry의 승인 상태를 파라미터로 받아 다음 단계로 넘기면서 작업 흐름을 제어하고, 실제 GPU 학습과 추론은 SageMaker가 수행합니다. 영역별로 맡은 일을 정리하면 아래 표와 같습니다.
| 관심사 | Argo Workflows | SageMaker |
|---|---|---|
| 흐름 제어 | DAG 순서, 게이트, 재시도, 알림 | - |
| 연산 실행 | - | Training Job, 실시간 엔드포인트 |
| 상태 관리 | 워크플로우 파라미터로 버전 전파 | Model Registry의 승인 상태 |
| 비용 관리 | 작은 제어용 파드만 상시 실행 | 학습은 잡 단위 과금, 서빙은 엔드포인트 인스턴스 시간 과금 |
SageMaker에서 가져다 쓴 기능
Argo 워크플로우(이하 파이프라인)는 SageMaker의 GPU나 CPU 같은 컴퓨팅 자원 말고도 아래 기능에 의존합니다.
- Model Registry는 ModelPackage마다
PendingManualApproval,Approved,Rejected같은 승인 상태를 관리합니다. 뒤에서 설명할 승급 게이트가 판정 결과를 이 상태로 남기고 배포 단계는Approved인 ModelPackage만 사용하므로, 후보 모델이 검증을 통과했는지 기록할 DB 테이블을 따로 둘 필요가 없습니다. - ProductionVariant의 Weight를 쓰면 엔드포인트 하나에 Variant를 여러 개 두고 각각의 트래픽 비중을 정할 수 있습니다. 신규 모델을 Weight 0으로 올려 두면 배포와 활성화가 분리됩니다.
- Inference Component로는 엔드포인트 하나에 모델을 여러 개 올려 두고, 호출할 때 어느 모델을 쓸지 지정할 수 있습니다. 저희는 현재 서비스 중인 모델(챔피언)과 이번 후보 모델(챌린저)을 같은 엔드포인트에 올려 같은 입력으로 비교하는 데 이 기능을 활용하고, 라이브 서빙은 앞의 Variant 방식으로 처리합니다.
- Serverless MLflow App 덕분에 실험 추적 서버를 상시 띄워 둘 필요가 없고, 쓰지 않을 때는 용량이 0까지 알아서 줄어듭니다.
파이프라인 전체 흐름
파이프라인은 각 단계의 워크플로우를 순서대로 실행하는 오케스트레이터와, 대부분의 스텝이 공통으로 쓰는 실행 바이너리(이하 러너)로 이루어져 있습니다. 매일 정해진 시각이 되면 CronWorkflow가 오케스트레이터를 띄우고, 오케스트레이터는 학습부터 배포, 피처 적재, 엔진 색인, 컷오버(세대 교체)까지 차례로 진행합니다.
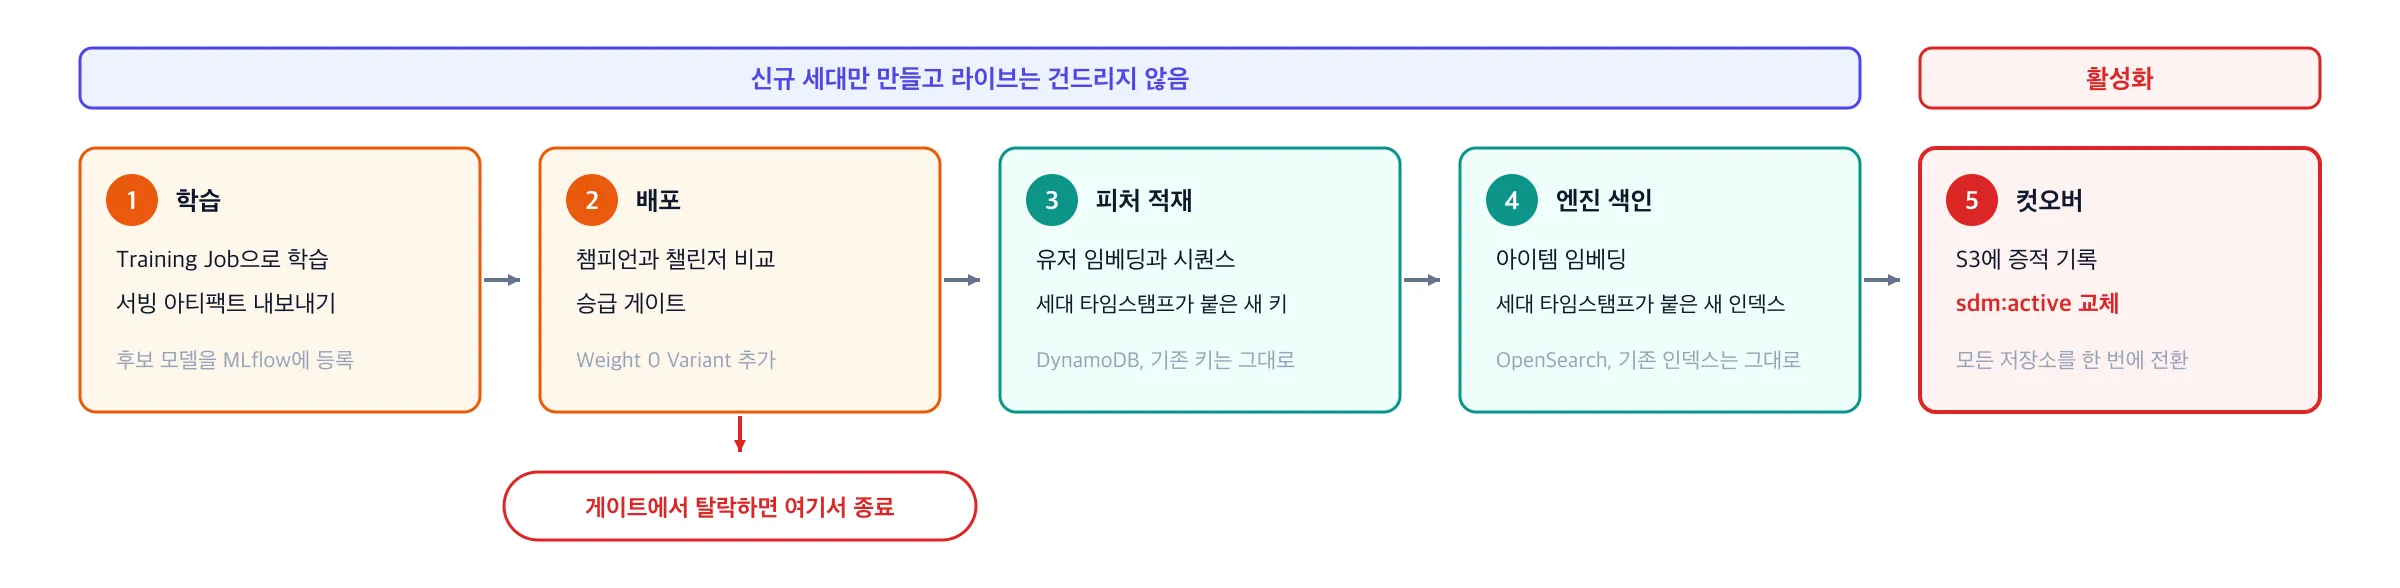
(그림: 컬리, © 2026. Kurly. All rights reserved.)
각 단계를 순차로 묶어 fail-fast로 처리하기 때문에 앞 단계가 실패하면 뒤 단계는 아예 스케줄되지 않고, 병렬로 돌렸다면 따로 만들어야 했을 ‘다른 단계를 뒤늦게 취소하는 로직’도 필요 없습니다. 전날 실행이 아직 끝나지 않았을 때 새 실행이 겹쳐 돌지 않도록 CronWorkflow에는 concurrencyPolicy: Forbid를, WorkflowTemplate에는 mutex를 함께 걸어 두었습니다.
세대 단위로 한 번에 바꾸기
용도에 따라 추론 모델은 SageMaker 엔드포인트에, 유저 임베딩은 DynamoDB에, 아이템 인덱스는 OpenSearch에 각각 나뉘어 있습니다. 저장소가 이렇게 제각각이라 한 트랜잭션으로 묶을 수 없었고, 대신 전환 지점을 한곳으로 모으는 방식으로 설계했습니다.
컷오버 전까지는 라이브를 건드리지 않는다
앞에서 오케스트레이터 구조를 소개할 때 잠깐 언급했듯이, 컷오버 단계 전까지는 어느 단계도 라이브 세대를 건드리지 않습니다.
- 배포 단계는 신규 Variant를 Weight 0으로 추가하기만 하고, 트래픽은 기존 Variant가 계속 처리합니다.
- 피처 적재와 엔진 색인은 각각 세대 타임스탬프가 붙은 새 키와 새 인덱스에 데이터를 쓰고, 기존 키와 인덱스는 그대로 둡니다.
마지막 컷오버 단계에서는 ElastiCache의 sdm:active에 이번 세대의 모델 버전을 씁니다. 산출물마다 세대를 가리키는 포인터도 따로 있지만, 이 포인터는 모델 버전별 네임스페이스로 나뉘어 있어서 각 적재 스텝이 신규 모델 버전 쪽에 미리 값을 써 두어도 라이브에서 사용하는 키는 바뀌지 않습니다.
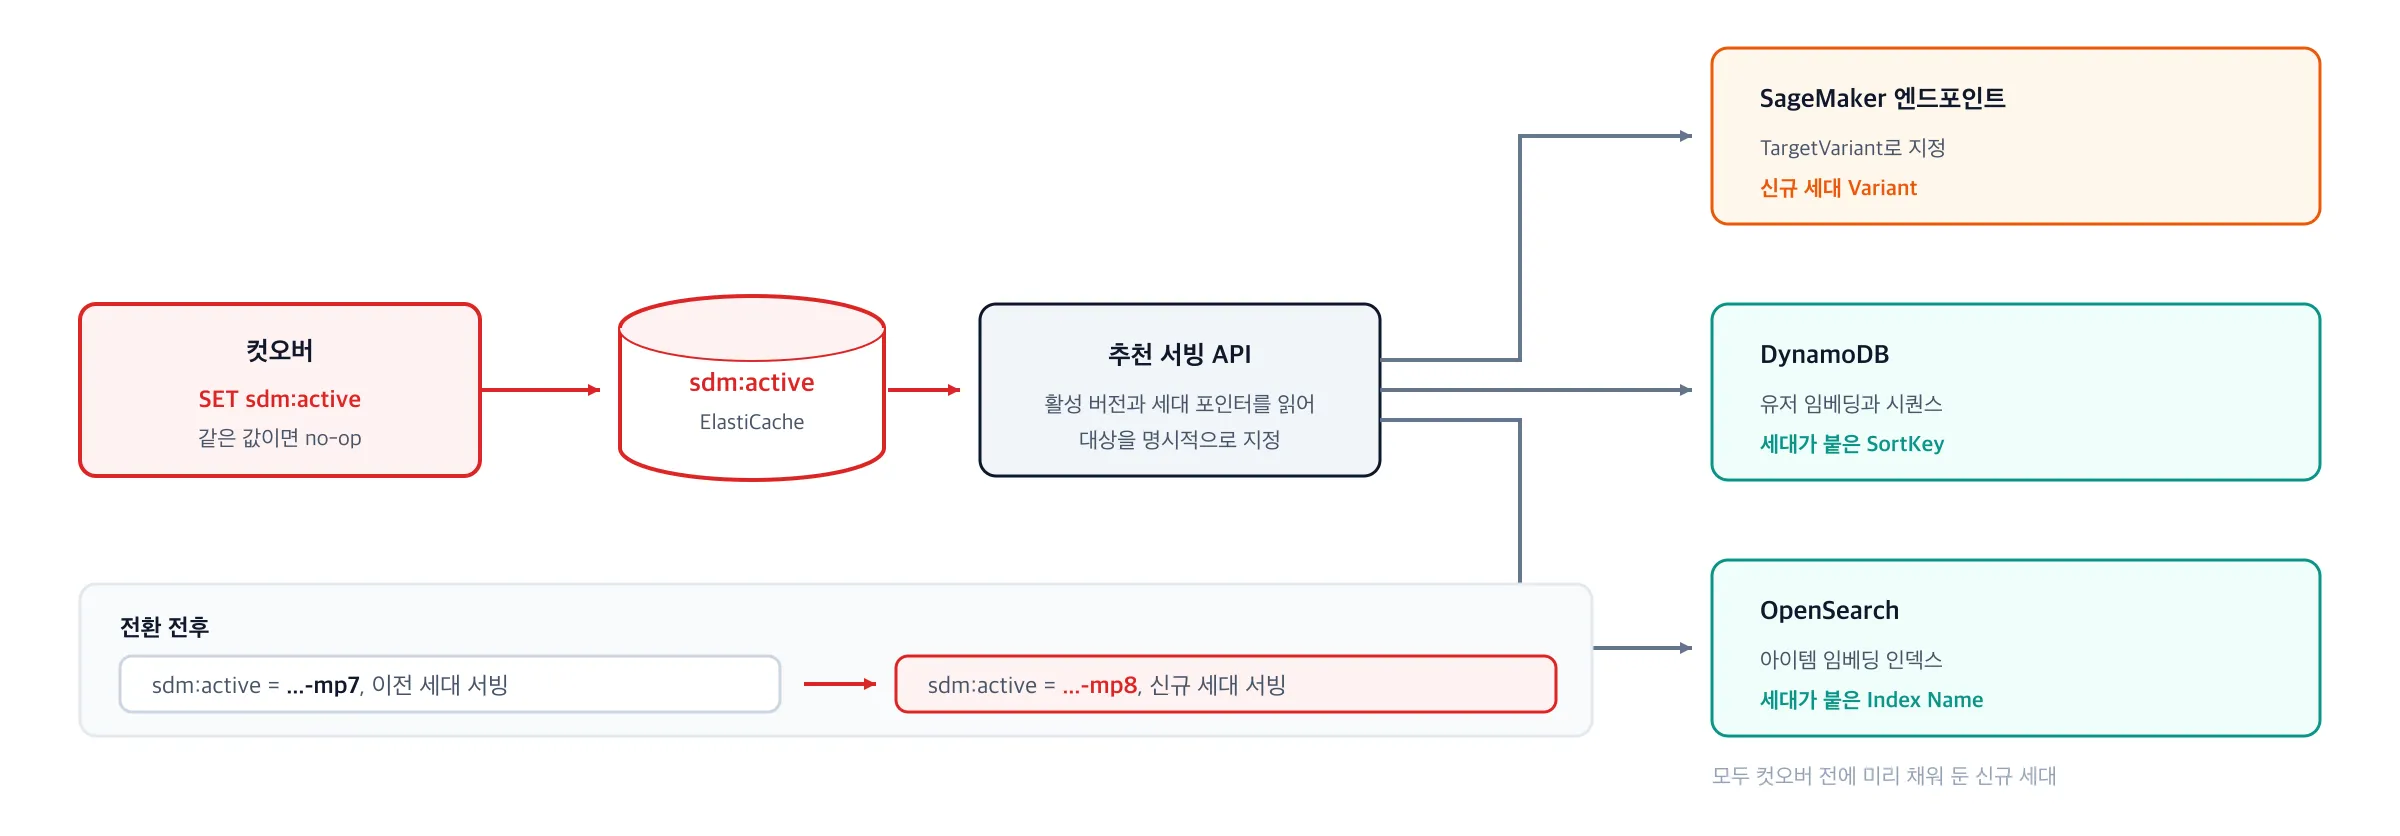
sdm:active와 그 아래 세대 포인터를 읽어 각 저장소를 명시적으로 지정합니다.(그림: 컬리, © 2026. Kurly. All rights reserved.)
이 방식이 동작하려면 서빙 API가 활성 세대를 명시적으로 지정해서 호출해야 합니다. 그래서 서빙 API는 요청마다 sdm:active에서 모델 버전을 알아내고, 그 버전의 세대 포인터를 읽어 사용할 세대를 확정합니다. 확정한 세대를 넘기는 방식은 저장소마다 다른데, SageMaker 엔드포인트에는 TargetVariant로, DynamoDB에는 세대가 붙은 SortKey로, OpenSearch에는 세대가 붙은 Index Name으로 전달합니다. OpenSearch의 alias 전환 기능을 쓰지 않고 인덱스 이름을 직접 넘기는 것도, alias와 활성 키를 따로 바꾸면 그 사이에 세대가 어긋나는 순간이 생기기 때문입니다. 앞 단계에서 신규 Variant가 미리 올라와 있더라도 sdm:active 키가 바뀌기 전까지는 아무도 그 Variant를 호출하지 않습니다.
sdm:active나 아이템 임베딩 세대를 가져오지 못하면 서빙 API는 이전 세대 데이터로 계속 동작합니다. 이런 상황이면 대개 이미 어딘가에 문제가 생긴 뒤인데, 이전 세대로 버티는 동안 정상화할 시간을 벌 수 있고 부분 장애가 유저에게까지 번지는 것도 막을 수 있습니다.
컷오버 단계에서 하는 일
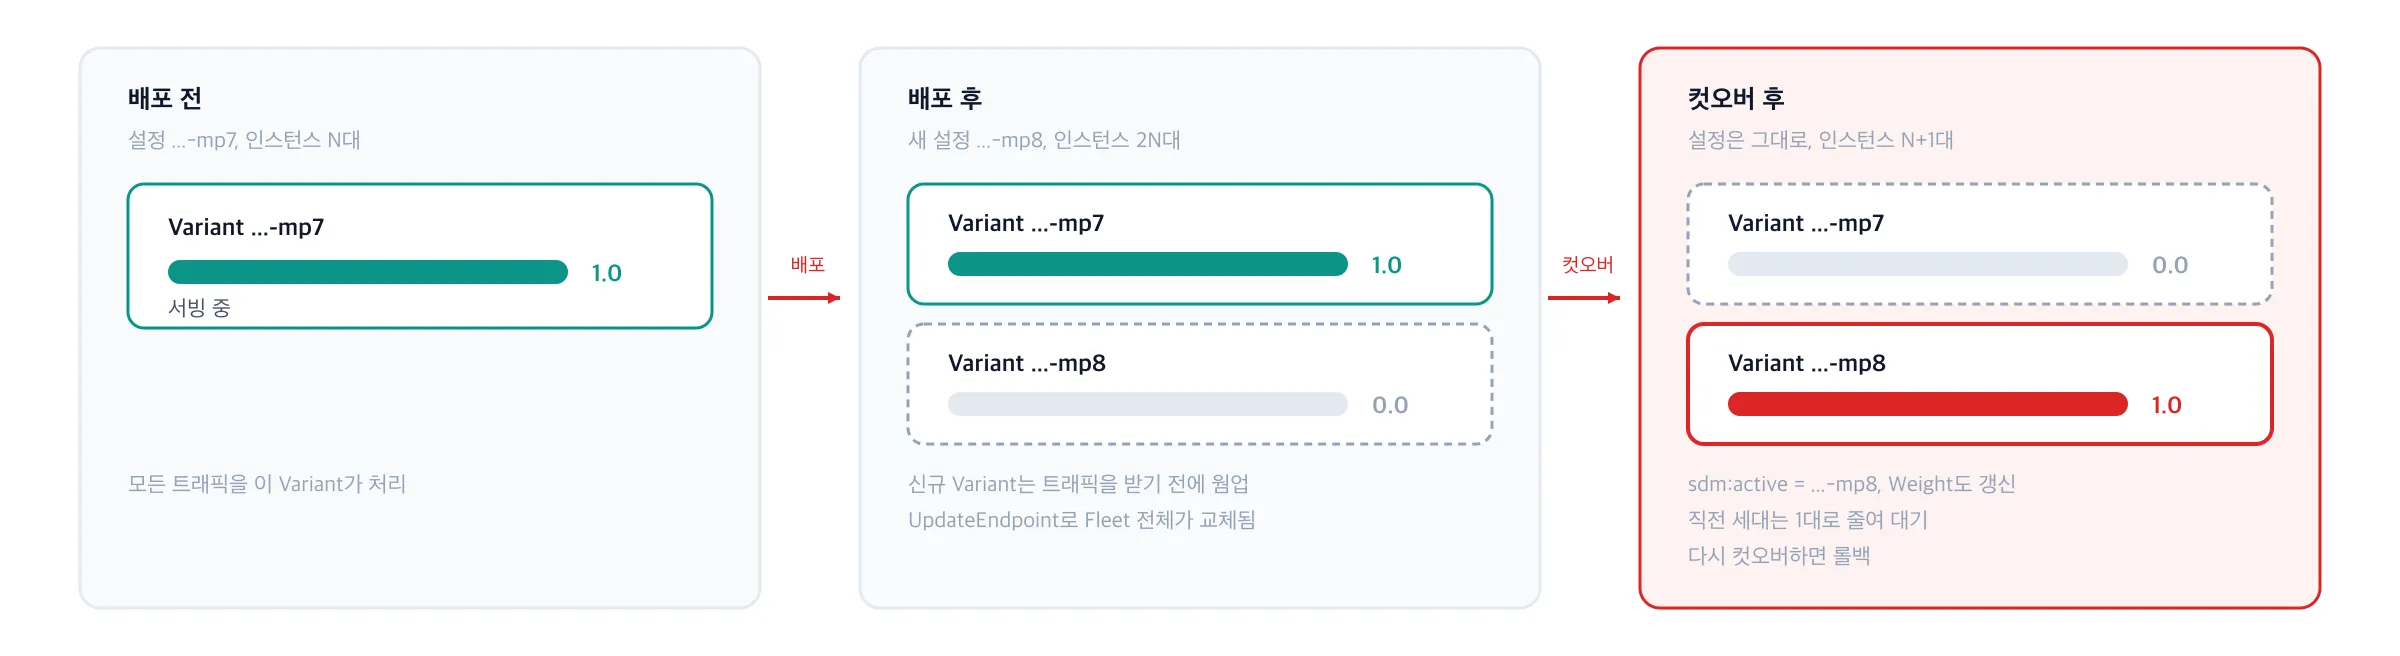
활성 키 하나를 SET하는 순간 서비스는 신규 세대로 넘어갑니다. 컷오버 단계에서는 먼저 이번 실행에서 무엇이 올라갔는지 S3에 증적을 남깁니다. 어떤 모델이 언제 서비스에 들어갔는지 추적하려면 이 증적이 꼭 있어야 하므로, 이 스텝이 성공해야만 다음 컷오버 스텝이 실행됩니다. 컷오버 스텝은 키를 바꾸기 전에 대상 Variant가 엔드포인트에서 InService 상태인지 확인하고, 아니라면 곧바로 실패 처리합니다. 전환한 뒤에는 Weight도 실제 서빙 상태에 맞게 바꿔 두어 AWS 콘솔에서도 어느 Variant가 트래픽을 받는지 알 수 있게 했습니다.
오케스트레이터는 시작할 때 세대 타임스탬프를 한 번 만들어 세대를 묶는 버전으로 쓰고, 이 값을 피처 적재와 엔진 색인, 컷오버에 그대로 전파합니다. 학습이나 사전 같은 데이터의 날짜도 파이프라인이 도는 날짜로 고정해 학습이 만든 데이터와 색인이 읽는 데이터의 정합성을 맞추는데, 덤으로 특정 날짜를 기준으로 다시 돌릴 때도 이 값을 그대로 쓸 수 있습니다.
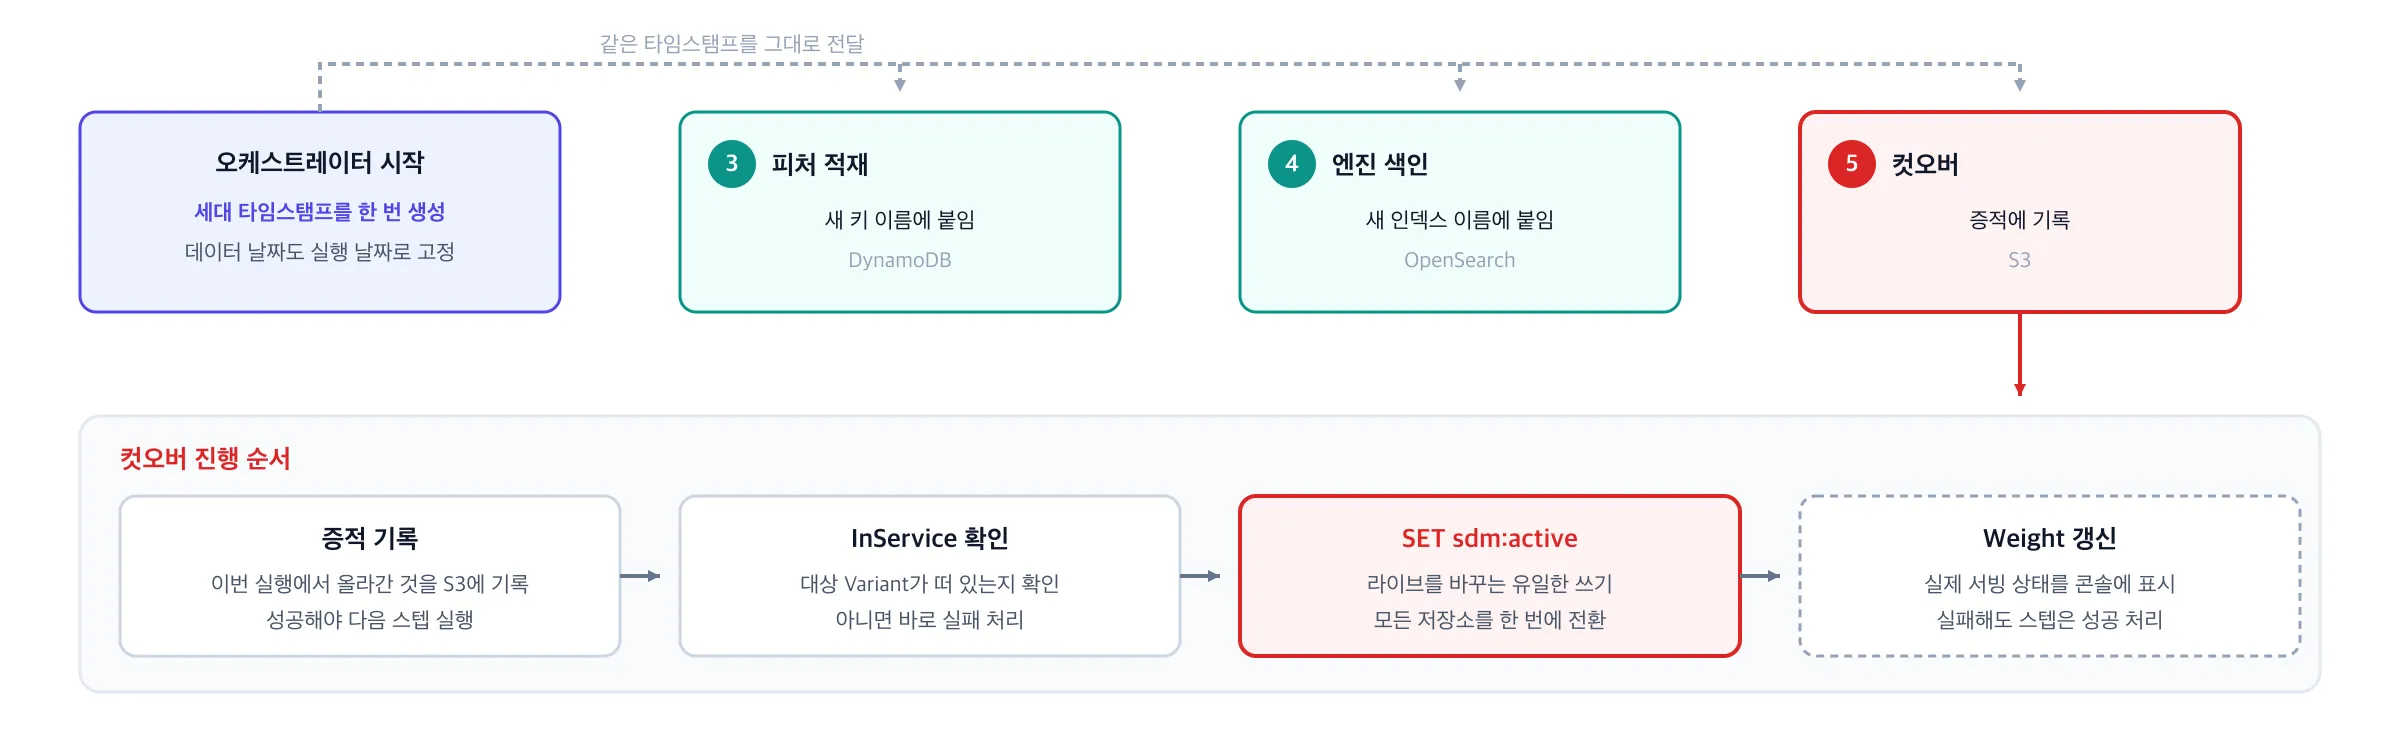
InService를 확인한 뒤에야 키를 바꿉니다.(그림: 컬리, © 2026. Kurly. All rights reserved.)
승급 게이트
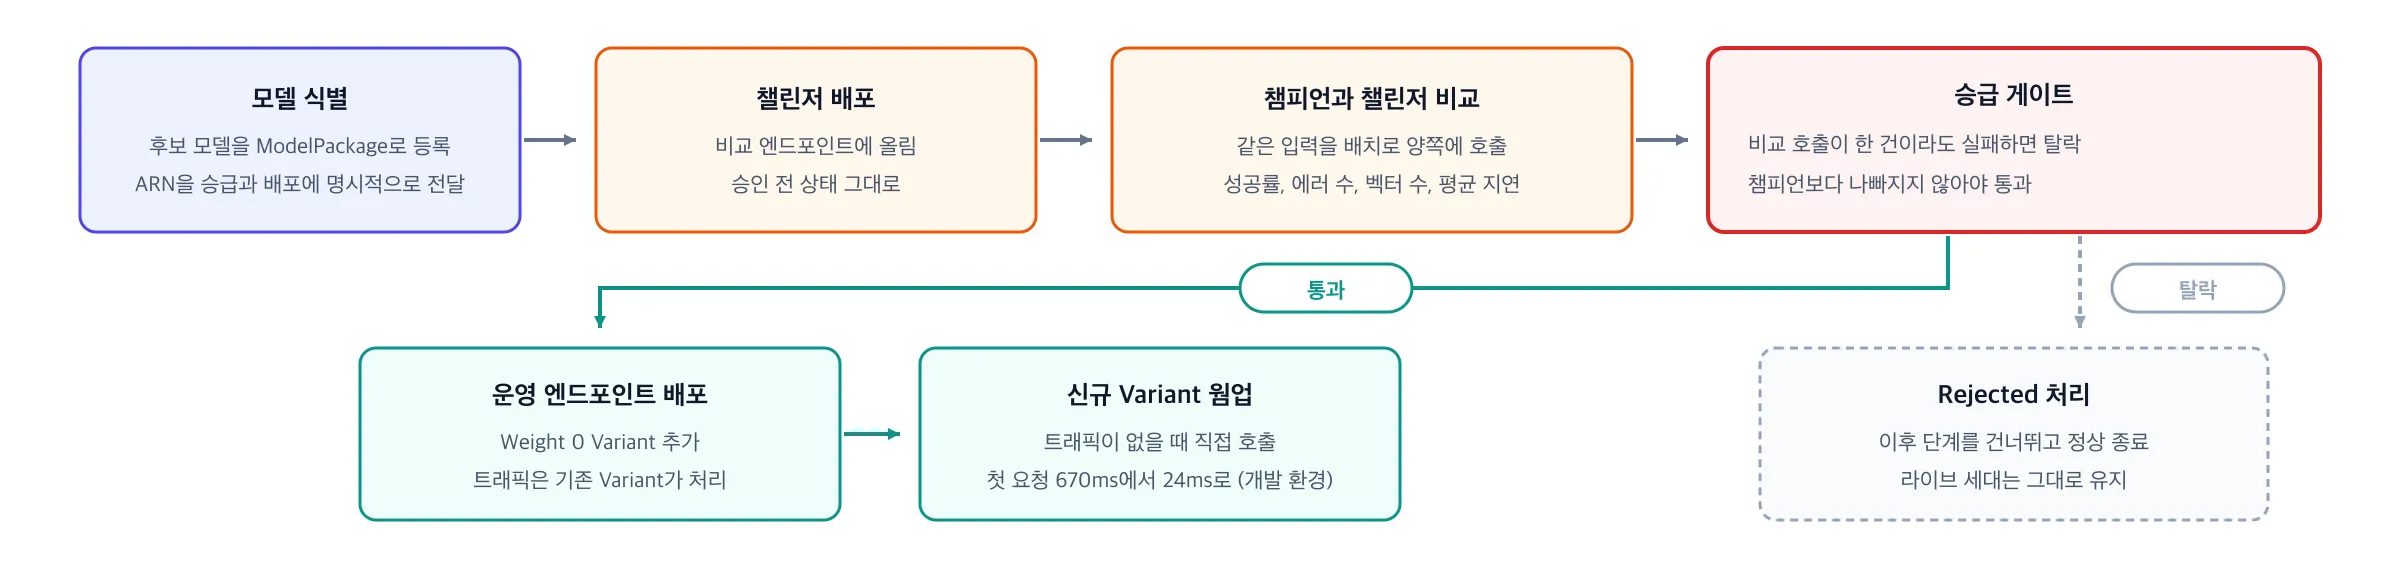
배포 워크플로우는 학습이 끝난 모델을 곧바로 올리지 않고, 아래 흐름처럼 검증을 통과한 모델만 내보냅니다.
(그림: 컬리, © 2026. Kurly. All rights reserved.)
챔피언과 나란히 띄워 비교
학습 단계에서 등록한 후보 모델은 승인 전 상태 그대로 별도의 비교 엔드포인트에 올라가 챔피언과 나란히 뜹니다. 비교 스텝은 같은 입력을 배치 단위로 양쪽에 보내고, 정상 여부를 판단할 근거로 성공률과 에러 수, 응답에 실제로 담긴 벡터 수, 평균 응답 지연을 모읍니다.
한 건이라도 실패하면 탈락
승급 게이트는 비교 호출이 한 건이라도 실패하면 후보를 통과시키지 않습니다. 품질 지표는 이미 학습 단계에서 계산해 MLflow에 기록하고 오프라인 품질 지표가 기준에 못 미치면 파이프라인이 학습 단계에서 멈추기 때문에, 배포 단계에서는 품질 지표가 아닌 기능 지표로 판정합니다.
배포 단계에서는 이번 모델이 추론 컨테이너에서 정말 뜨는지, 실제 요청 형식으로 호출했을 때 제대로 된 응답을 돌려주는지를 확인합니다. 드물긴 하지만 학습은 성공했어도 서빙 아티팩트 변환이 어긋나거나 추론 핸들러의 입력 시그니처가 바뀌면, 오프라인 지표는 모두 정상인데 추론 엔드포인트에서만 문제가 생깁니다. 온라인 비교는 이렇게 실제로 추론해 봐야만 드러나는 문제를 잡아냅니다. 승급 게이트를 통과하지 못하면 ModelPackage는 Rejected 상태가 되고, 파이프라인은 피처 적재부터 컷오버까지를 건너뛴 채 정상 종료하므로 라이브 세대는 그대로 남습니다.
배포와 롤백
학습이든 엔진 색인이든 어느 단계에서 실패하더라도 그 시점까지 만들어진 건 아직 아무도 보지 않는 신규 세대일 뿐이라서, 다음 날 다시 돌리면 그만입니다.
기존 Variant는 지우지 않는다
EndpointConfig는 immutable이라서 배포할 때마다 새 설정을 만들고, 이름이 고정된 엔드포인트가 가리키는 설정만 UpdateEndpoint로 바꿉니다. 새 설정에는 기존 Variant를 그대로 둔 채 신규 Variant를 Weight 0으로 덧붙입니다.
(그림: 컬리, © 2026. Kurly. All rights reserved.)
설정에 담긴 Variant 수만큼 인스턴스가 뜨기 때문에 라이브 설정에는 직전 세대와 신규 세대만 남기고, 그보다 오래된 세대는 쌓아 두지 않습니다. 처음에는 Variant마다 인스턴스 대수를 고정해 두어 상시 2배수가 떴고, 세대를 곧바로 되돌릴 수 있는 여지를 얻는 대신 유휴 인스턴스 비용을 감수했습니다. 하지만 물러난 직전 세대는 롤백할 일이 없으면 그대로 낭비라서, 지금은 서빙 Variant에 인스턴스당 호출 수를 기준으로 오토 스케일링을 걸고 컷오버가 끝나면 직전 세대 Variant를 1대로 줄입니다. Variant 이름이 배포마다 바뀌기 때문에 오토 스케일링 등록과 해제도 콘솔에서 한 번 해 두는 대신 배포와 컷오버 단계가 매번 처리합니다. 10월에 이렇게 바꾼 뒤로 평소에 떠 있는 인스턴스는 이전의 3분의 2 수준으로 줄었고, 호출이 몰릴 때만 이전만큼 늘어납니다.
배포 직후 응답이 느려진 이유
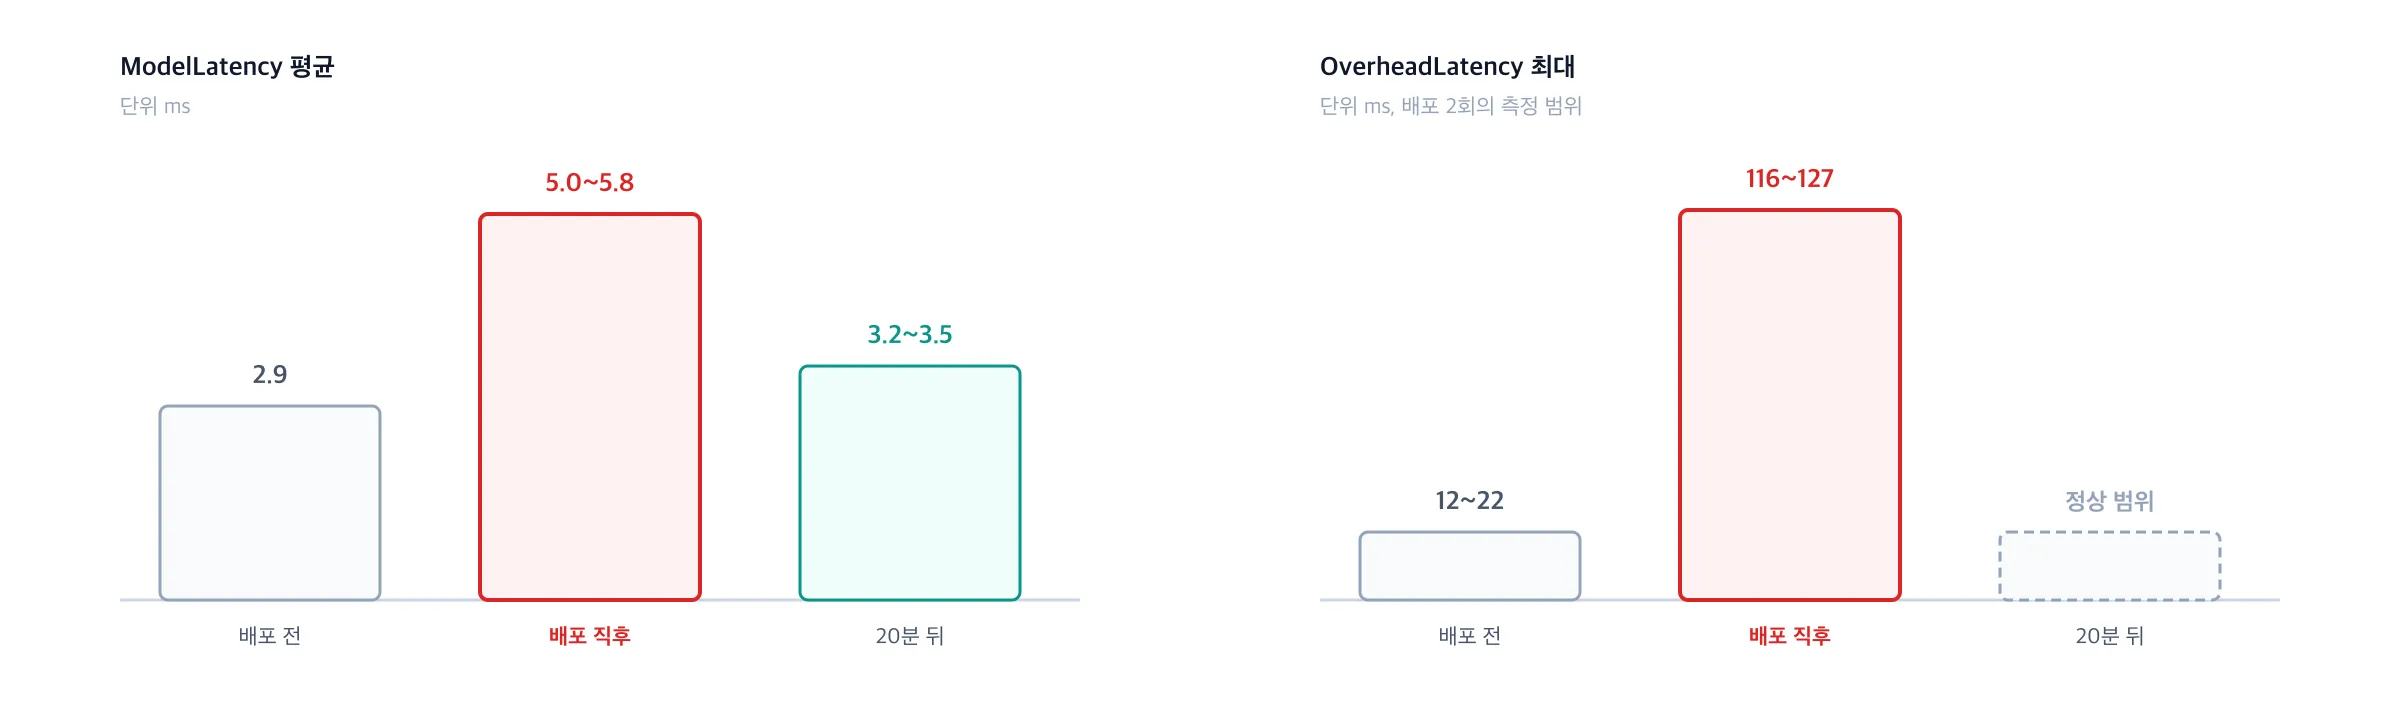
Weight 0 Variant는 컷오버 전까지 실트래픽을 한 번도 받지 않습니다. 그대로 두면 교체 직후 들어온 첫 실요청에서야 ONNX 런타임의 lazy 초기화가 일어나 응답이 늦어지고, 호출 측 타임아웃에 걸려 실패로 처리되거나 폴백 로직으로 넘어갈 수 있습니다. 이를 막으려고 엔드포인트를 배포한 직후 신규 Variant를 직접 지정해 웜업 호출을 보내서, 실트래픽이 들어오기 전에 초기화를 끝내 둡니다.
그런데 예상하지 못한 문제가 더 있었는데, UpdateEndpoint는 Weight 0 Variant를 추가하기만 해도 엔드포인트 Fleet을 통째로 새 인스턴스로 교체했습니다. UpdateEndpoint API 문서에도 “Deploys the EndpointConfig specified in the request to a new fleet of instances”라고 적혀 있습니다. 앞에서 말한 “라이브를 건드리지 않는다”는 설명은 설정 수준에서만 맞는 말이었고, 서빙 중이던 Variant도 이 시점에 Cold 상태로 다시 뜰 수 있었습니다. 같은 문서가 약속하는 것도 “there is no availability loss”까지였습니다. AWS가 보장하는 건 가용성이지 지연이 아니었으므로, 추론 컨테이너가 모델을 로딩할 때 웜업까지 마쳐 두는 처리도 반드시 필요했습니다.
(그림: 컬리, © 2026. Kurly. All rights reserved.)
저희는 추론 인스턴스마다 여럿 뜨는 TorchServe Worker를 유력한 원인으로 보았습니다. 추론 서버가 헬스체크에 OK를 응답하기 전에 모델을 로딩만 하고 Forward pass를 돌리지 않으면, Worker마다 Cold 상태로 첫 요청을 받을 수 있기 때문입니다. 그래서 모델을 로딩한 직후 Forward pass를 한 번 돌려 Worker가 뜨는 시점에 초기화를 마쳐 두도록 바꿨고, 결과적으로 웜업은 신규 Variant를 배포하는 단계와 추론 코드에 모두 들어가게 됐습니다.
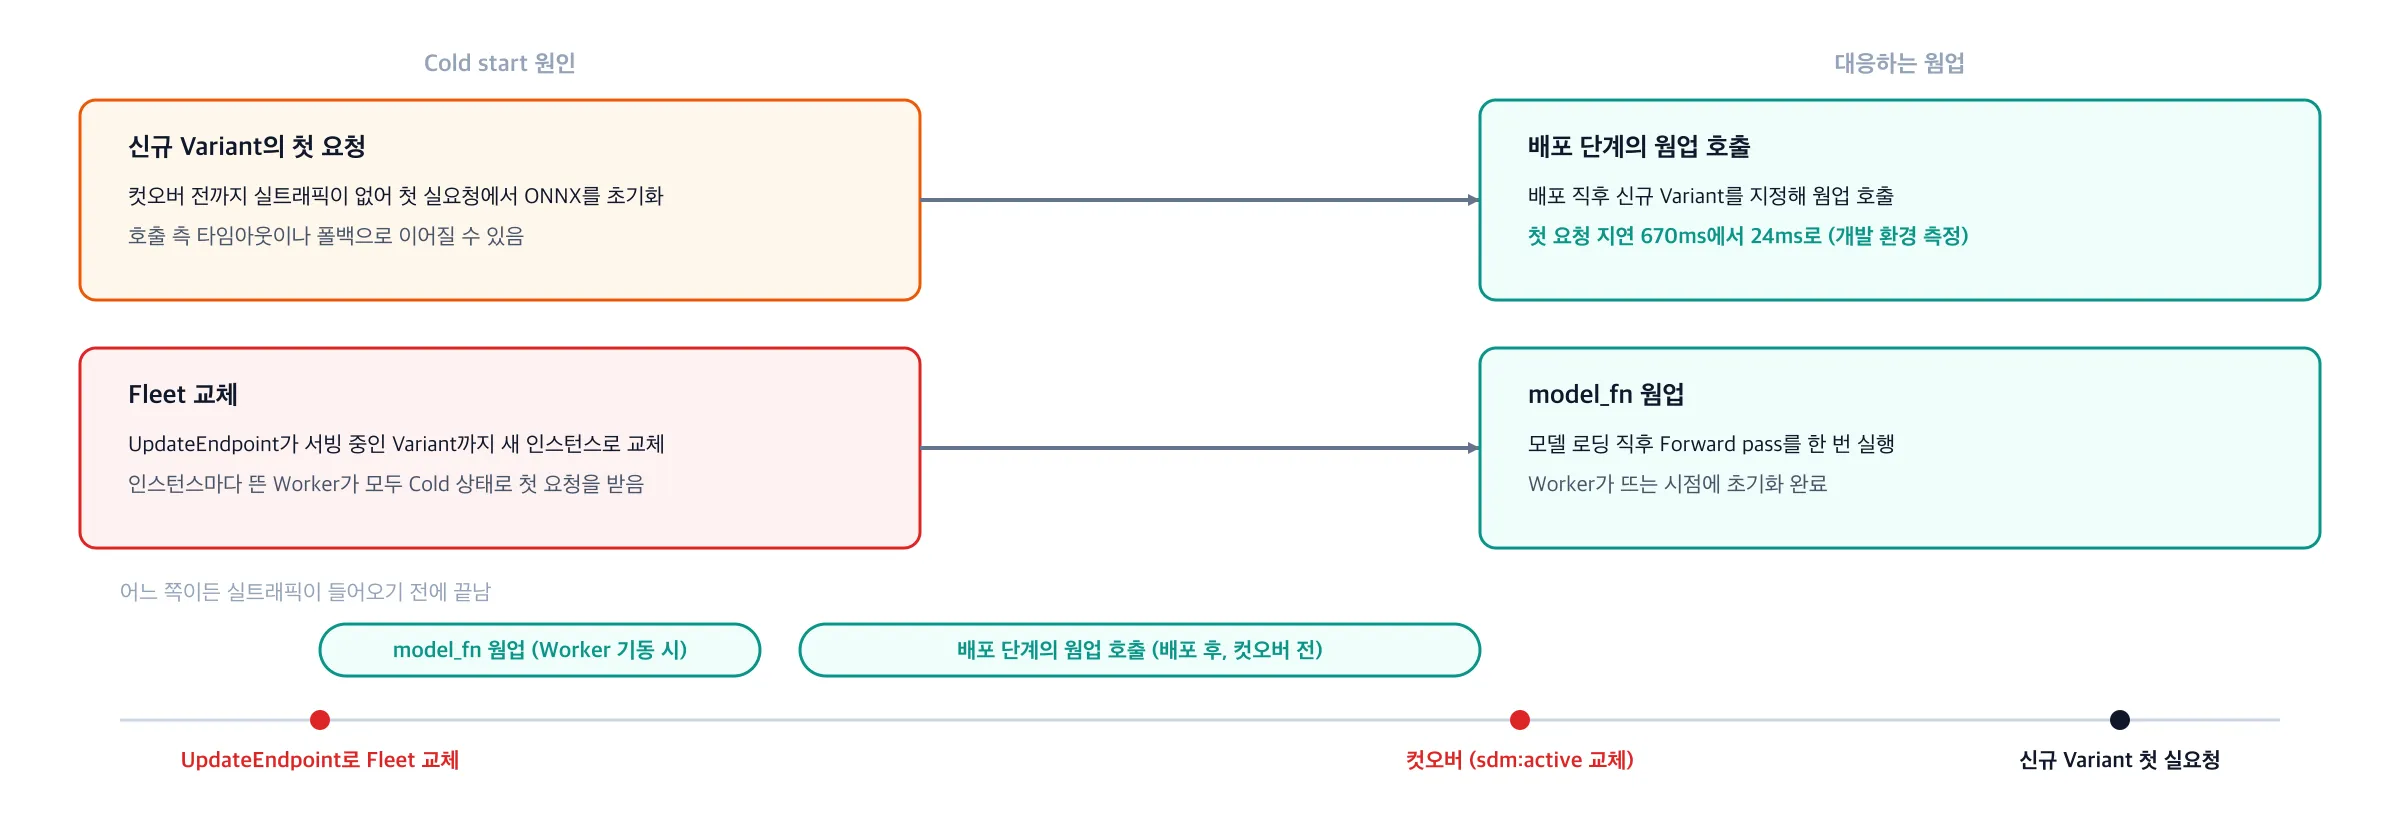
model_fn의 웜업이 맡습니다. 어느 쪽이든 실트래픽이 들어오기 전에 실행됩니다.(그림: 컬리, © 2026. Kurly. All rights reserved.)
언제까지 되돌릴 수 있나
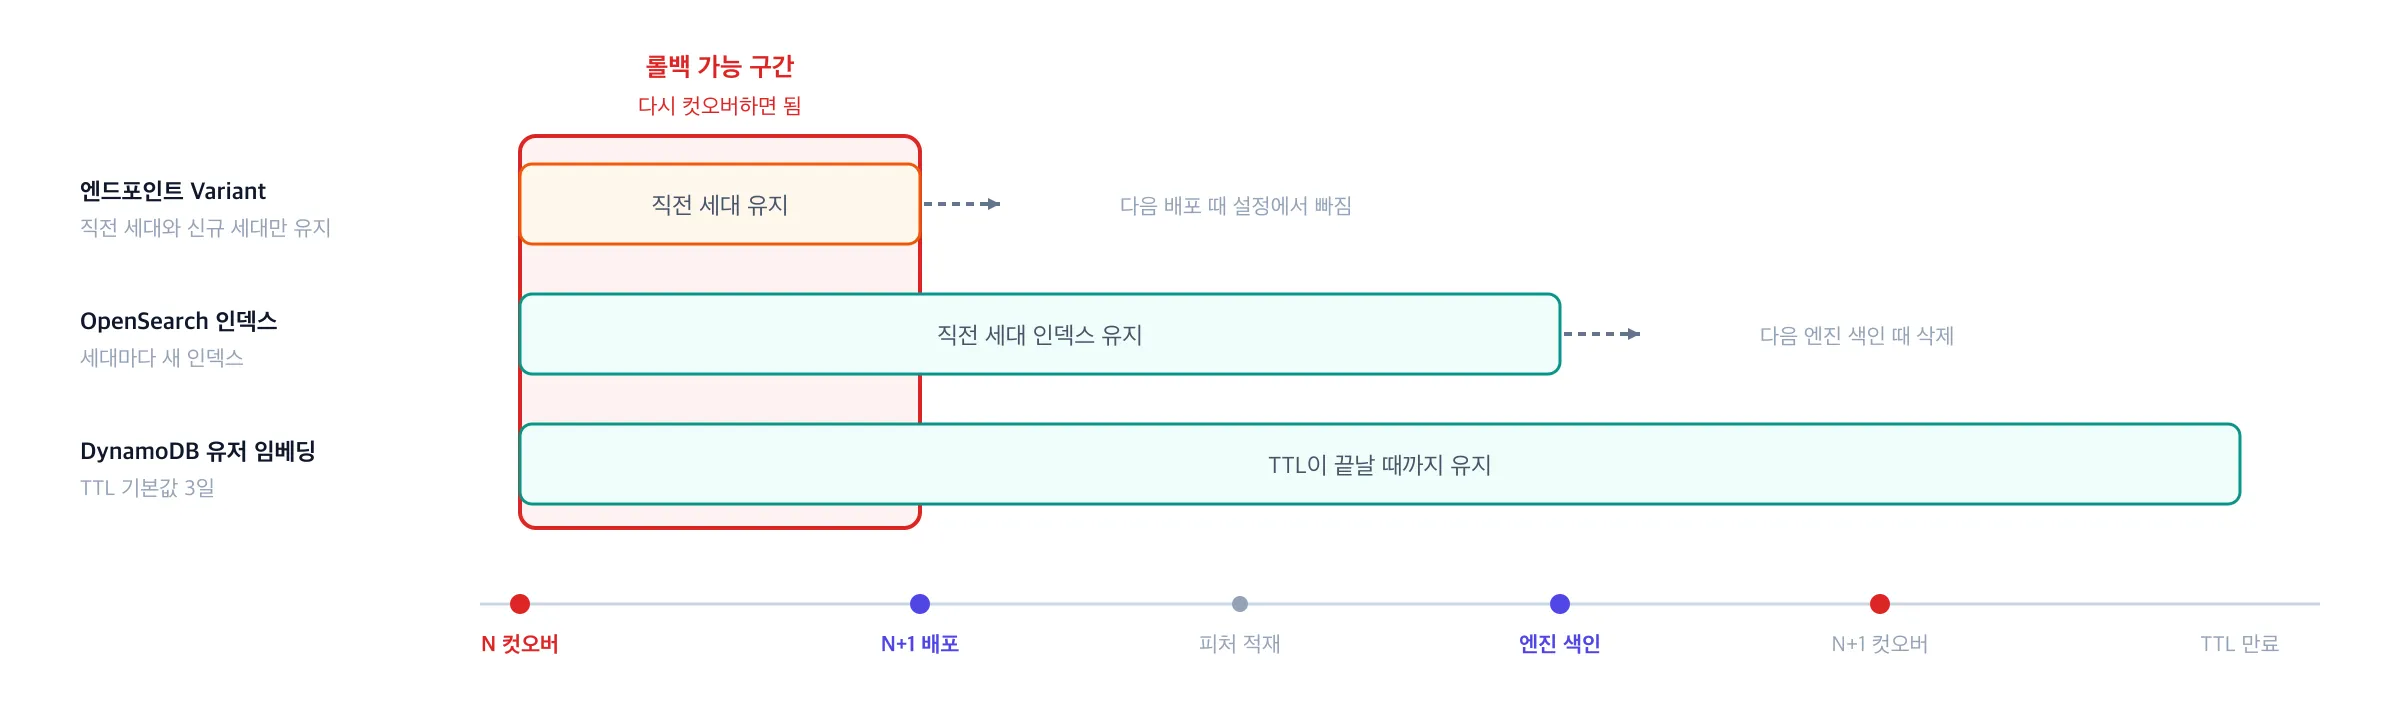
엔드포인트 설정에 직전 세대 Variant가 남아 있으니, 롤백도 새 엔드포인트를 띄울 필요 없이 이전 모델 버전으로 컷오버를 한 번 더 돌리면 됩니다. 이때 1대로 줄어 있던 직전 세대가 트래픽을 한꺼번에 받지 않도록, 컷오버는 활성 키를 되돌리기 전에 대상 Variant를 서빙 중인 세대와 같은 대수까지 먼저 늘리고 InService가 될 때까지 기다립니다. 정해 둔 시간 안에 늘어나지 않으면 키를 바꾸지 않고 스텝을 실패로 끝냅니다.
물론 돌아갈 세대가 아직 살아 있어야 가능한 이야기인데, 저희 정책상 엔드포인트 Variant와 OpenSearch 인덱스는 다음 실행이 신규 세대를 만드는 동안 남아 있고 DynamoDB의 유저 임베딩은 TTL이 끝날 때까지 유지됩니다. 산출물마다 남아 있는 기간이 다르니 롤백할 때는 이 차이도 함께 고려해야 합니다.
(그림: 컬리, © 2026. Kurly. All rights reserved.)
파이프라인 내부 구조
왜 워크플로우를 단계마다 나눴나
모든 단계를 워크플로우 하나에 몰아넣을 수도 있었지만, 일부러 단계마다 나눴습니다. 우선 학습만 다시 돌리거나 배포만 다시 하는 일이 자주 생겨서 각 워크플로우는 혼자서도 돌 수 있어야 했습니다. 게다가 학습과 배포, 색인을 서로 다른 조직이 맡고 있어서, 하나로 모으면 누가 무엇을 고쳐야 하는지 경계가 흐려집니다.
이렇게 나눈 워크플로우는 오케스트레이터가 자식 워크플로우로 제출하고 끝날 때까지 기다리면서 하나로 이어 줍니다. 자식 워크플로우 입장에서는 혼자 실행될 때와 다를 게 없습니다.
자식 Workflow는 Argo의 resource 템플릿으로 만들고, 제출과 대기를 별도 스텝으로 나눴습니다. 몇 시간씩 걸리는 학습을 기다리는 동안 대기 파드가 노드 교체 같은 이유로 사라질 수 있는데, 제출과 대기가 한 스텝에 묶여 있으면 그 스텝을 재시도할 때 자식이 한 번 더 제출됩니다. 그래서 자식을 만드는 제출 스텝은 재시도하지 않고, 자식의 상태를 조회하기만 하는 대기 스텝만 재시도합니다. 자식의 출력 파라미터도 대기 스텝이 뽑아 다음 단계에 넘기는데, 배포 단계를 예로 들어 간추리면 다음과 같습니다.
# 제출: 자식 Workflow를 만들기만 하고 재시도하지 않는다
- name: submit-deploy
  resource:
    action: create
    setOwnerReference: true
    manifest: |
      apiVersion: argoproj.io/v1alpha1
      kind: Workflow
      metadata:
        generateName: mlops-deploy-
      spec:
        workflowTemplateRef:
          name: mlops-deploy-workflow-template

# 대기: 자식 상태를 조회만 하므로 다시 시도해도 안전하다
- name: wait-deploy
  retryStrategy:
    limit: "3"
    retryPolicy: Always
  resource:
    action: get
    successCondition: status.phase == Succeeded
    failureCondition: status.phase in (Failed, Error)
    manifest: |
      apiVersion: argoproj.io/v1alpha1
      kind: Workflow
      metadata:
        name: "{{inputs.parameters.workflow_name}}"
  outputs:
    parameters:
      - name: promoted
        default: "false"
        valueFrom:
jsonPath: '{.status.outputs.parameters[?(@.name=="promoted")].value}'promoted의 기본값을 "false"로 둔 것은 승급 게이트의 결과를 읽지 못했을 때 통과하지 못한 것으로 보고 컷오버를 하지 않기 위해서입니다.
실행 코드를 러너로 모으기
스텝을 하나하나 뜯어보면 결국 AWS API 호출인데, 스텝마다 Python이나 셸 스크립트를 따로 만들면 SDK 호출 코드가 여기저기 흩어지고 재시도 정책이나 멱등 처리, 에러 메시지 형식도 제각각이 됩니다. 이를 피하려고 리소스 프로비저닝부터 학습 제출과 폴링, 모델 등록, 비교와 승급 판정, 배포, 웜업, 컷오버까지의 스텝을 Java fat jar 하나에 서브커맨드로 묶었습니다. DynamoDB와 OpenSearch에 데이터를 적재하는 스텝은 같은 방식으로 만든 별도의 jar가 맡습니다.
러너로 묶고 나니 이미지 태그만으로 파이프라인 버전이 고정되고, 입출력 규약도 한곳에서 통제할 수 있었습니다. 분기가 많은 로직은 클러스터에 올려 보지 않고 단위 테스트로 확인합니다. 다만 워크플로우 명세와 러너가 서로 다른 리포지터리에 있다 보니, 배포 순서와 인터페이스 규약은 팀 안에서 따로 공유해 둬야 했습니다.
리소스를 만들고 정리하는 시점
파이프라인이 쓰는 SageMaker 리소스는 수명에 따라 한 번 만들어 계속 쓰는 것과 매번 새로 만드는 것으로 나뉩니다.
| 구분 | 리소스 | 담당 |
|---|---|---|
| 한 번 만들어 재사용 | MLflow App, ModelPackageGroup, 비교 엔드포인트 | 부트스트랩 워크플로우 |
| 실행마다 새로 생성 | Model, EndpointConfig | 배포 워크플로우 |
Model과 EndpointConfig는 immutable이라 매번 새로 만들지만, MLflow App과 ModelPackageGroup은 배포 시점과 상관없이 살아 있어야 하므로 부트스트랩 워크플로우가 한 번 만들어 두고 이후에는 멱등하게 확인만 합니다. 지난 세대의 Model과 EndpointConfig는 자동으로 지우지 않고, 많이 쌓이면 그때 수동으로 정리합니다. 잘못 지웠을 때의 위험이 쌓아 두는 부담보다 훨씬 크고, 라이브 설정에서 빠진 세대는 인스턴스를 띄우지 않으니 비용 영향도 크지 않기 때문입니다.
매일 알아서 돌아가게 하려면
남은 요구사항은 학습부터 색인까지 매일 자동으로 이어지게 하는 일입니다. 파이프라인은 정해진 시각에 알아서 돌지만, 어떤 날은 중간에 멈추기도 합니다. 그런 날에도 중간 상태를 손으로 맞추지 않고 그냥 처음부터 다시 돌리고 싶었고, 그러려면 멱등성이 필요했습니다.
멱등성과 재시도
어느 스텝에서 멈추든 다시 돌릴 수 있도록 모든 쓰기 동작을 멱등하게 만들었습니다. 같은 아카이브를 다시 등록하면 기존 ARN을 돌려주고, 같은 버전이 이미 엔드포인트에 배포되어 있거나 컷오버에서 같은 값을 한 번 더 SET하면 no-op으로 지나갑니다. 이미 끝난 스텝은 다시 실행돼도 상태가 바뀌지 않으니 처음부터 다시 돌려도 괜찮습니다.
재시도는 스텝 단위와 실행 단위로 나뉘는데, 스텝 재시도는 각 워크플로우의 retryStrategy가 맡습니다. 오케스트레이터는 앞에서 본 대기 스텝만 재시도하고 실행 전체는 재시도하지 않으므로, 실행 전체를 다시 돌릴 때는 워크플로우를 새로 제출하고, 이때도 원래 처리하려던 날짜의 데이터를 써야 하므로 data_date는 실패한 실행과 같은 값으로 넘깁니다.
서비스로 전환해도 되는지 판단하기 애매한 상황에서는 기본값을 안전한 쪽으로 잡았습니다.
- 배포된 적 없는 버전으로 트래픽이 넘어가는 사고를 막기 위해, 앞서 말한 대로 컷오버는 대상 Variant가 엔드포인트에서
InService상태가 아니면 활성 포인터를 바꾸지 않습니다. - 비교할 챔피언이 있는 실행에서 어느 한쪽 신호라도 빠지면 후보가 나빠지지 않았다는 걸 검증할 수 없으므로, 승급 게이트는 후보를 통과시키지 않습니다.
- 사람이
Rejected로 바꾼 패키지는 재실행해도 되살아나지 않습니다. 거부된 ARN을 성공으로 흘려보내면 배포 단계에서 뒤늦게 실패해 원인을 찾기 어려워질 수 있다고 판단했기 때문입니다.
Slack 스레드로 진행 상황 공유
파이프라인을 한 번 실행할 때마다 오케스트레이터가 Slack에 부모 메시지를 만들고, 자식 워크플로우가 그 스레드에 답글을 다는 방식으로 진행 상황을 운영자에게 전달합니다. 실제 알림 문구를 간추리면 다음과 같습니다.
⏳ [prod] ML 파이프라인 시작
    ⏳ 모델 학습 시작
    ✅ 모델 학습 + 임베딩 추출 완료
    ⏳ 모델 배포 시작
    ✅ 승급 게이트 결과: 통과
    ⏳ 피처 적재 시작
    ✅ 피처 적재 완료
    ⏳ 엔진 색인 시작
    ✅ 엔진 색인 완료
    🚀 컷오버 완료. 서비스 투입
    ✅ ML 파이프라인 종료
스레드 끝만 봐도 파이프라인이 어디까지 진행됐고 결과가 어땠는지 알 수 있습니다. 컷오버까지 끝났다면 지금 서비스 중인 세대가 그 실행의 학습 결과이고, 중간에 멈췄다면 라이브는 이전 세대 그대로이니 다시 돌리기만 하면 됩니다. 승급 게이트에서 걸린 실행은 유관 부서와 공유해 확인한 뒤 재실행합니다. 어느 경우든 사람이 끼어들 일은 되도록 줄이려고 했습니다.
적용 결과
갱신 주기
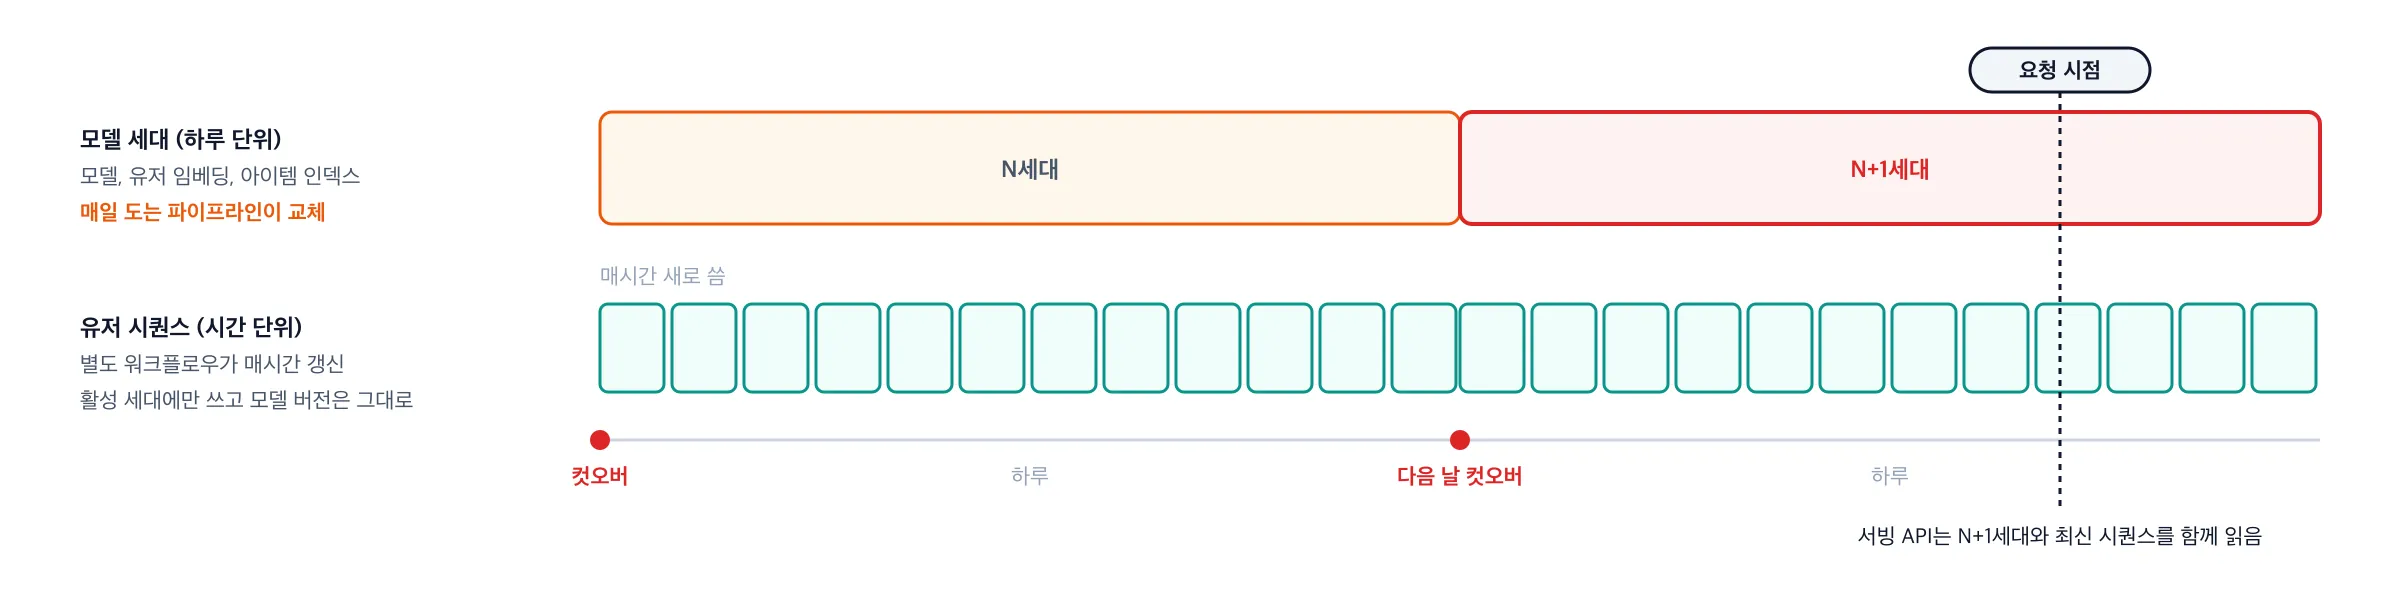
현재 추천 모델은 하루 단위로 바뀌고, 그 모델에 들어가는 입력은 시간 단위로 바뀝니다. 매일 도는 이 파이프라인이 모델과 유저 임베딩, 아이템 인덱스를 한 세대로 묶어 통째로 교체하고, 매시간 도는 배치가 유저 시퀀스를 갱신합니다. 유저 인코더(H)가 이 시퀀스를 입력으로 받기 때문에 세대가 그대로인 하루 동안에도 최근 세션의 의도가 추천에 반영됩니다.
(그림: 컬리, © 2026. Kurly. All rights reserved.)
시간 단위 배치는 별도 워크플로우라 이 글에서 자세히 다루지는 않지만, 세대 교체와 어긋나지 않도록 sdm:active가 가리키는 활성 세대에 시퀀스를 쓰기만 하고 모델 버전은 건드리지 않게 설계했다는 점만 짚고 넘어가겠습니다.
지표 변화
아래 결과는 이 파이프라인이 매일 올리는 모델에서 나왔지만, 파이프라인이 맡은 건 추천 모델을 매일 같은 방식으로 서비스에 올리는 일이고 지표가 좋아진 건 함께 진행한 모델 구조 개편 덕분입니다. 개편 전에는 추천 서비스마다 모델의 형태와 서빙 방식이 달랐고, 이를 통합해 관리하는 체계도 없었습니다. 그래서 모델을 모든 지면이 함께 쓰는 코어와 지면별 리랭크로 나눴고, 그 코어를 세대 단위로 갈아 끼우는 일이 이 파이프라인의 몫이 됐습니다.
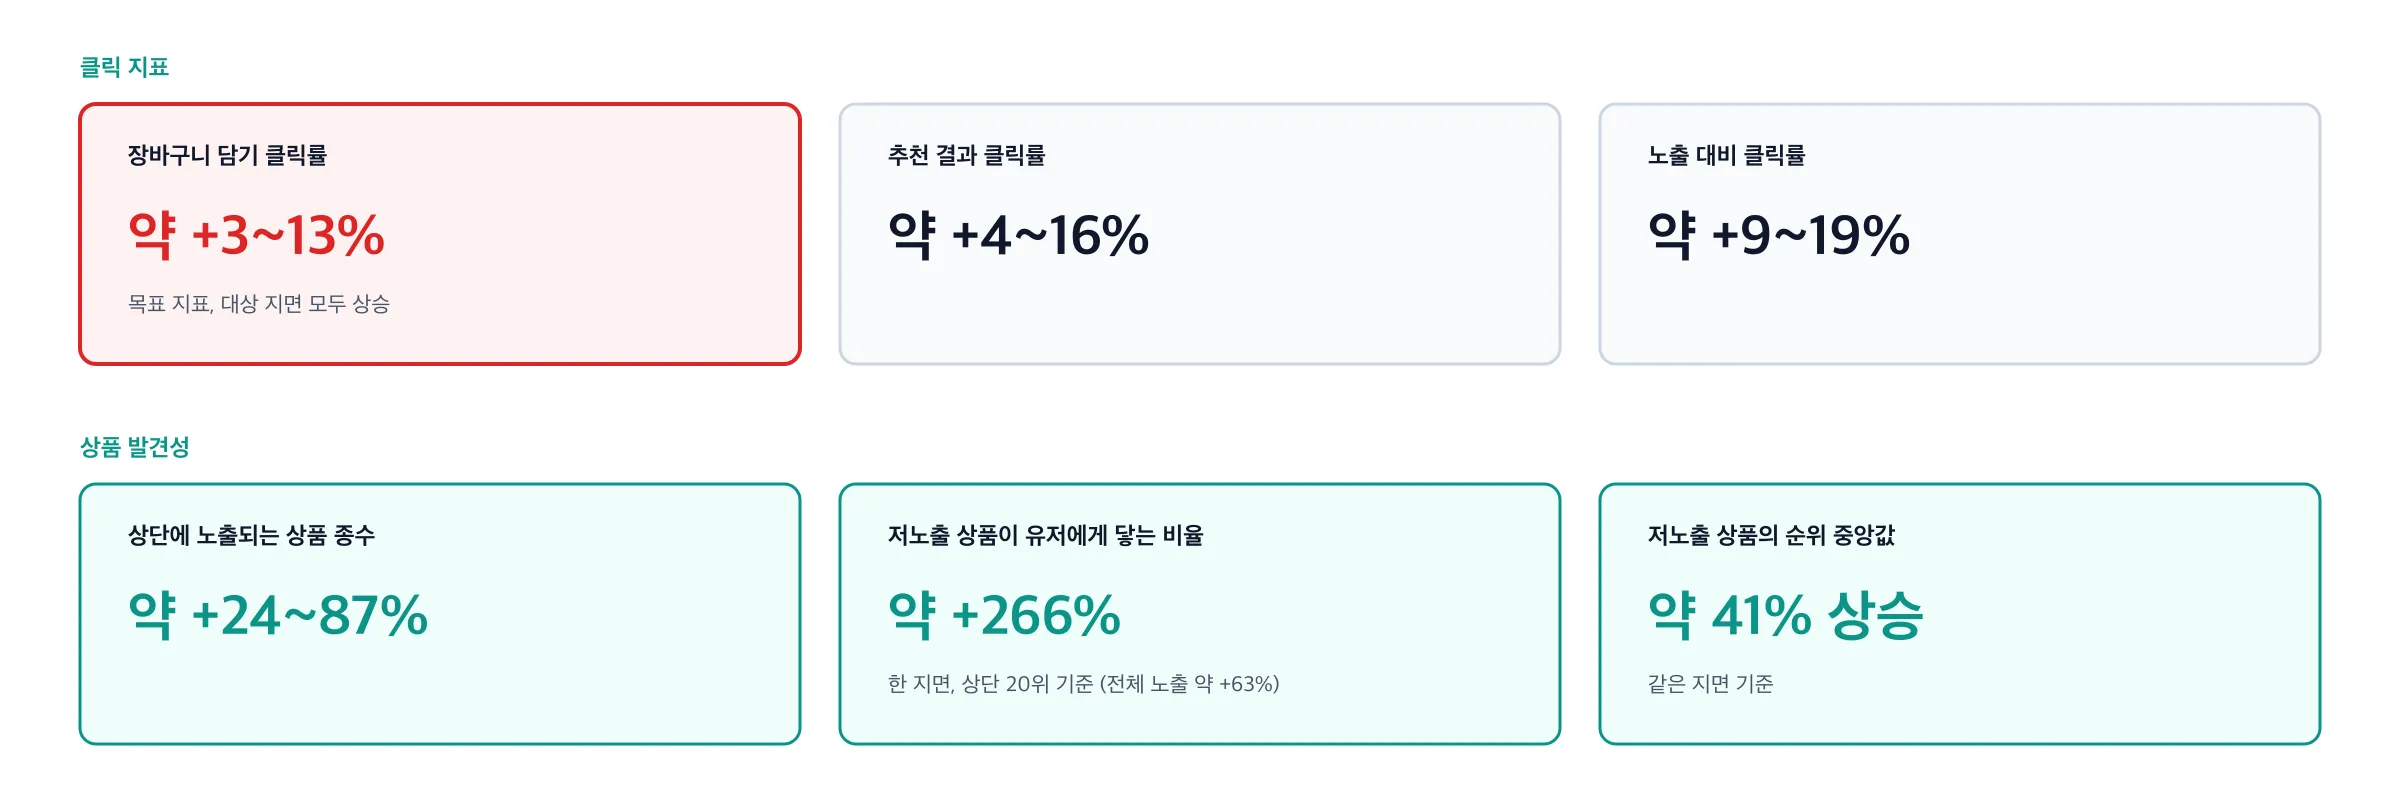
개편 후에는 코어가 만든 후보를 지면별 리랭크가 각 지면의 목적에 맞게 다시 줄 세우면서, 그동안 노출이 적었던 상품이 상단까지 올라오고 유저가 만나는 상품의 폭도 넓어졌습니다.
(그림: 컬리, © 2026. Kurly. All rights reserved.)
실험은 7월 중순부터 8월 하순까지 네 지면에서 일주일 이내씩 진행했고, 앱에 로그인한 유저를 무작위로 나눠 기존 모델과 새 구조를 비교했습니다. 목표 지표로 잡은 유저 단위 장바구니 담기 클릭률은 대상 지면 모두에서 올랐고, 상승 폭은 지면에 따라 약 3~13%였습니다. 추천 결과 클릭률과 노출 대비 클릭률, 상단에 노출되는 상품 종수도 여러 지면에서 함께 늘었습니다. 한 지면을 따로 떼어 보면 노출이 적던 상품이 유저에게 닿는 비율과 그 상품의 순위가 모두 개선됐고, 클릭한 유저 한 명이 클릭한 상품 수는 평균 약 8%, 클릭 수는 평균 약 9% 늘었습니다. 숫자로 보면 더 많은 유저가 더 다양한 상품을 클릭하게 된 셈입니다.
회고
돌아보면 오케스트레이션과 ML 런타임의 역할 경계를 분명히 그어 둔 덕을 많이 봤습니다. Argo는 실행 흐름만 알고, 러너는 AWS API를 호출해 작업을 끝까지 마무리하는 데만 집중합니다. ML 런타임을 SageMaker에 맡기면서 GPU를 어떻게 효율적으로 쓸지, GPU 환경을 어떻게 구축하고 운영할지에 들일 품도 덜었습니다. 학습이나 서빙 방식이 바뀌더라도 오케스트레이션은 손대지 않고 인터페이스만 맞춰 해당 모듈을 갈아 끼우면 됩니다.
멱등성을 챙겨 둔 것도 운영을 단순하게 만드는 데 한몫했습니다. 파이프라인 일부가 실패해도 원인을 찾아 해결한 뒤 다시 돌리면 이미 끝난 스텝은 그냥 지나가니, 사실상 중단된 부분부터 이어 갈 수 있었습니다.
다 만들고 나서 보니 처음부터 확실히 정해 뒀으면 좋았을 것들이 보여 몇 가지 정리해 봤습니다.
활성 버전을 가리키는 지점은 하나만 두는 게 좋습니다. 저희는 캐시 키 하나를 썼는데, 서빙이 그 값을 읽어 대상을 명시적으로 지정하는 구조라면 나머지 설계가 전부 단순해집니다. 중간에 실패하더라도 복구 로직이나 부분 롤백 없이 다시 돌리기만 하면 됩니다.
리소스 이름은 버전에서 결정론적으로 정해지게 하세요. 저희가 겪은 문제의 절반은 모델 자체가 아니라 이름과 타입, 상태가 서로 어긋난 데서 나왔습니다. 모델 버전 하나에서 Model 이름과 설정 이름, Variant 이름, 저장소 키가 모두 같은 규칙으로 나오게 하면 충돌이나 불일치가 크게 줄어듭니다.
“알아서 최신을 고르는” 기본 동작은 자동화에서 피하는 편이 낫습니다. 개발이나 테스트 중에 손으로 한 번 돌릴 때는 편하지만 매일 자동으로 도는 파이프라인에서는 결과가 어긋나는 원인이 되므로, 값은 명시적으로 지정해서 넘기는 쪽이 안전합니다.
관리형 서비스가 보장하는 범위는 문서에서 직접 확인해야 합니다. 저희는 Weight 0이 “이 Variant로 트래픽이 안 간다”와 “엔드포인트가 안 바뀐다”를 함께 보장한다고 읽었는데, 실제로 보장되는 건 트래픽 쪽뿐이었고 그 차이가 앞에서 본 배포 직후의 지연으로 나타났습니다. 무중단을 목표로 설계했다면 그 무중단이 어느 계층까지인지 꼭 검증해 보세요.
감사의 말
설계가 막힐 때마다 같이 고민해 주신 팀 동료분들, 전체 파이프라인 구현을 도와주신 여러 실무 담당자분들, 인프라 정책과 IAM 구성을 함께 풀어 주신 분들께 감사드립니다. 비슷한 구조를 고민하고 계신 분들께 이 글이 참고가 되면 좋겠습니다. 긴 글 읽어 주셔서 감사합니다.